

6 minutos de lectura
La IA necesita información de calidad para generar respuestas fiables y los medios pueden ofrecérsela, pero necesitan saber qué ocurre con sus contenidos una vez que entran en los sistemas de IA. Para ello, la Coalición SPUR ha desarrollado Content Telemetry, un estándar abierto que busca establecer un lenguaje común para mejorar la trazabilidad, la transparencia y la capacidad de los editores para negociar en un ecosistema de IA cada vez más dependiente de sus contenidos.
Durante los últimos años, la relación entre los medios de comunicación y las plataformas de IA Generativa se ha parecido a un juego del ratón y el gato: ante el rastreo automatizado de contenidos, muchos editores han recurrido a herramientas como robots.txt, bloqueos de agentes o restricciones a nivel de servidor para decidir qué sistemas pueden acceder a sus páginas.
Pero el problema va más allá de permitir o impedir el acceso. Una vez que un sistema de IA recupera el contenido, el editor pierde gran parte de la visibilidad sobre lo que ocurre después. Los registros del servidor o de la CDN pueden indicar que un bot ha solicitado una determinada URL, pero esa señal sólo permite observar una parte del recorrido del contenido.
El medio puede saber que su artículo ha sido recuperado, pero no necesariamente si ha terminado formando parte del contexto utilizado para generar una respuesta, si ha sido citado como fuente, si esa referencia se ha mostrado al usuario o si ha generado alguna interacción.
Y aquí aparece una nueva asimetría de fondo: mientras las plataformas de IA pueden conocer qué contenidos utilizan y qué papel desempeñan en sus respuestas, los editores disponen de una visibilidad mucho más limitada sobre ese recorrido. Por ello, el reto ya no consiste únicamente en saber quién accede al contenido, sino en poder conocer qué ocurre con él después de ese acceso.
Para abordar el problema, la SPUR Coalition ha desarrollado Content Telemetry, un estándar abierto que propone un lenguaje común para registrar y comunicar las distintas etapas del uso de un contenido dentro de los sistemas de IA.
¿Qué es SPUR Coalition?
SPUR (Standards for Publishers Usage Rights) es una alianza internacional sin ánimo de lucro impulsada por organizaciones dedicadas a la creación de periodismo original. Entre sus miembros fundadores se encuentran BBC, Financial Times, Guardian Media Group, Sky News, Telegraph Media Group, Mediahuis, Associated Press y CMA Media. Actualmente, está abierta a nuevos miembros y cuenta con ocho líneas de trabajo.
La coalición no tiene como objetivo negociar las licencias en nombre de los medios (ya que cada editor sigue siendo libre de cerrar sus propios acuerdos comerciales con OpenAI, Perplexity, Google o cualquier otra plataforma). En cambio, su meta es establecer estándares y marcos técnicos y comerciales comunes para que el consumo de periodismo por parte de la IA sea más transparente, trazable y medible.
“El seguimiento de cómo los sistemas de IA utilizan el contenido genera beneficios para todos los implicados. Un estándar común implica que los sistemas de IA y sus usuarios se benefician de resultados mejores y más relevantes. Para los creadores de contenido, ver cómo y dónde su trabajo aporta valor dentro del entorno de la IA les ayuda a comprender dónde concentrar su energía y recursos para esa audiencia”. Jon Slade, director ejecutivo de Financial Times y miembro fundador de la Coalición SPUR.
El problema: la opacidad tras la petición HTTP
Hasta ahora, si un servidor o la infraestructura del medio detectaba la visita de un bot de IA, podía saber que una determinada URL había sido solicitada, pero no qué ocurría con el contenido a partir de ese momento:
- ¿Ese contenido llegó a formar parte del contexto utilizado para generar una respuesta?
- ¿Fue citado como fuente?
- ¿La referencia llegó a mostrarse al usuario?
- ¿Generó alguna interacción?
Si la plataforma de IA almacena la información en caché y la reutiliza mil veces para responder a distintos usuarios, el servidor del medio no registrará ni una sola visita adicional. El contenido puede seguir utilizándose, pero el editor pierde visibilidad sobre ese impacto.
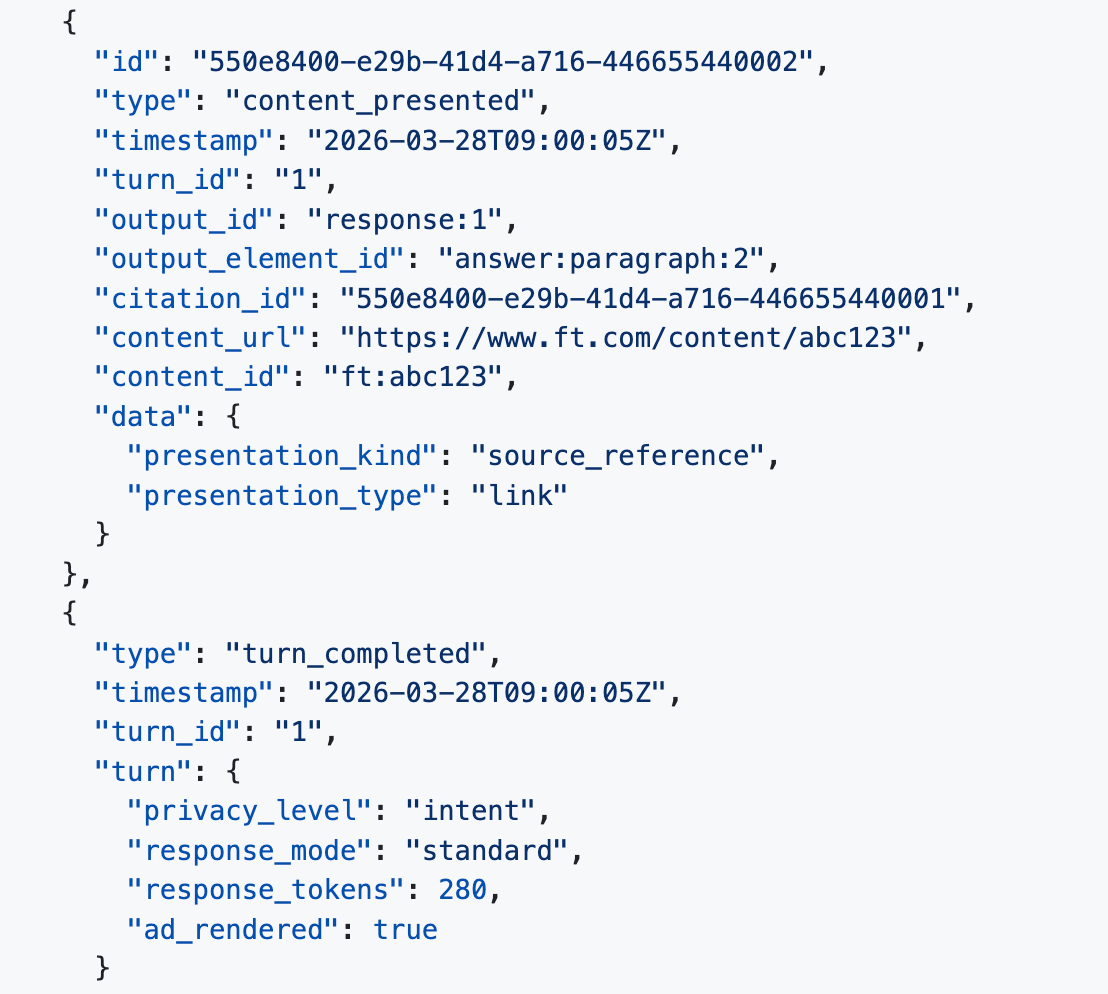
SPUR lo ilustra con un ejemplo: un usuario consulta a un agente de IA sobre los tipos de interés en el Reino Unido. El agente basa su respuesta en un artículo del Financial Times almacenado en caché, lo cita y muestra un enlace. El usuario lee la respuesta y se marcha sin hacer clic en el enlace.
Fuente: https://www.spurcoalition.org.
La solución: el estándar Content Telemetry
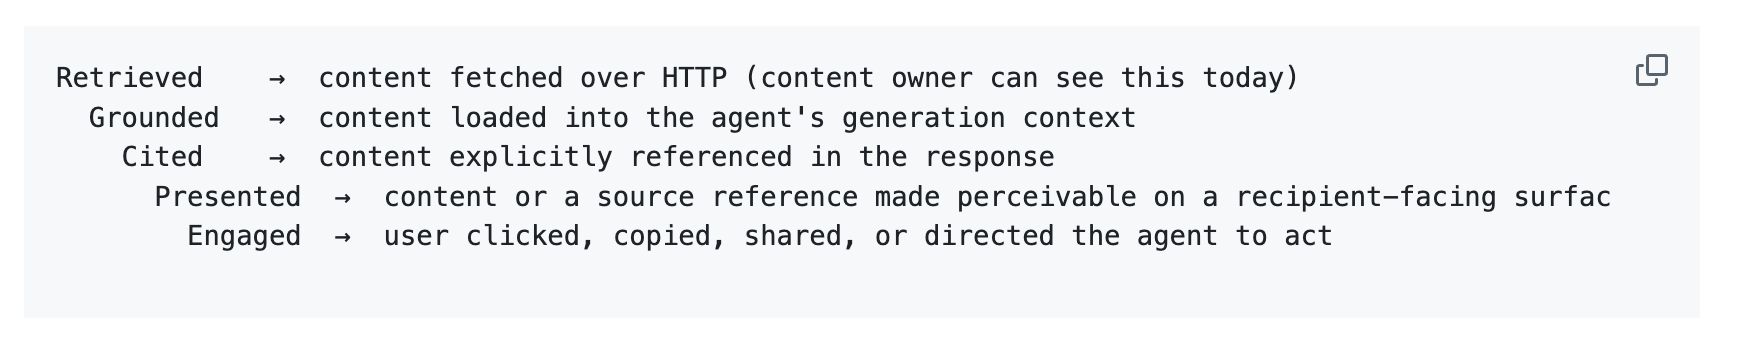
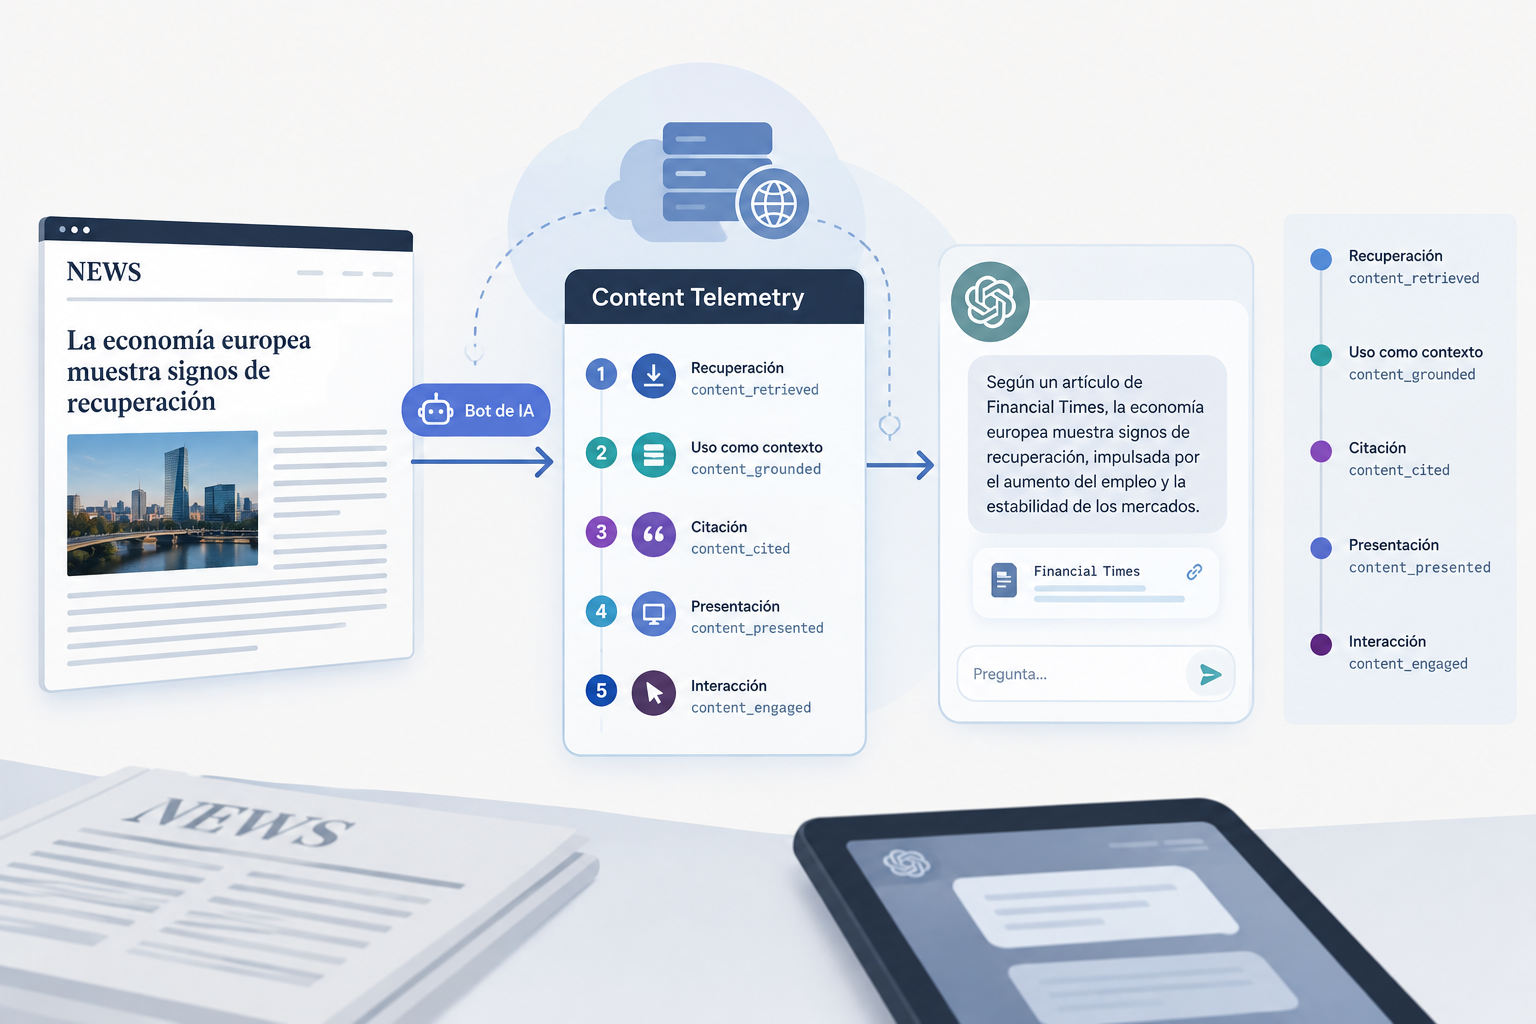
Para resolver esta asimetría, SPUR ha publicado el pasado 2 de septiembre las especificaciones de Content Telemetry (versión 1.0), un estándar abierto que define el “viaje” del contenido dentro de un sistema de IA a través de 5 eventos clave:
-
Recuperación (content_retrieved): el bot obtiene el artículo mediante una petición HTTP (la única fase visible desde la infraestructura tradicional del medio).
-
Fundamentación (content_grounded): el contenido entra formalmente en el contexto de generación de la respuesta. Es especialmente relevante porque permite registrar usos de un artículo previamente almacenado en caché, incluso cuando no se produce una nueva petición al servidor del medio.
-
Citación (content_cited): la salida del modelo asocia de forma explícita una afirmación o fragmento con el artículo original.
-
Presentación (content_presented): el contenido o su referencia se hace perceptible, por ejemplo mediante un enlace, una tarjeta o incluso otros formatos como voz, aunque no significa necesariamente que el usuario haya visto o interactuado con esa referencia.
-
Interacción (content_engaged): el usuario realiza una acción sobre la referencia (un clic, desplegar la fuente, copiar el texto, etc.).
Fuente: https://github.com/SPUR-Coalition/telemetry.
Gracias a esta estructura, los editores podrán empezar a medir las distintas etapas del recorrido del contenido: ¿Cuántas veces un contenido recuperado acaba fundamentando una respuesta?, ¿Cuántas de esas fundamentaciones terminan generando una cita? ¿Y cuántas referencias presentadas al usuario generan finalmente una interacción?
La clave es que estos eventos pueden registrarse con un mismo lenguaje técnico, lo que facilita el intercambio de información entre los distintos actores del ecosistema. Ahora bien, los cinco eventos no siempre se dan en ese orden ni todos a la vez.
Fundamentalmente, Content Telemetry responde a un problema de trazabilidad. Como señala Alex Springer, responsable técnico de la Coalición SPUR, su objetivo es “desarrollar un lenguaje común para medir e informar sobre el uso del contenido, sobre el cual pueden construirse los marcos de licencias y compensación”.
Por qué la telemetría puede cambiar la negociación de licencias
La telemetría no fija precios, pero cambia las reglas del juego en la mesa de negociación:
-
Datos estructurados y trazables, en lugar de estimaciones: la estandarización de los eventos puede proporcionar a los medios una base común para analizar y contrastar cómo se utiliza su contenido en los sistemas de IA.
-
Soberanía del dato: permite a los medios locales y regionales proteger su identidad informativa y exigir que su contenido no se diluya en la masa algorítmica sin la debida atribución y compensación.
-
Un vocabulario unificado: el sector editorial necesita un estándar para definir qué constituye un “uso” de contenido en la era de la IA (sin él, cada plataforma puede seguir reportando cifras distintas e incomparables).
Todo esto supone un avance muy importante para los medios, ya que aporta una estructura común para hacer más transparente y trazable el uso de sus contenidos, al tiempo que puede proporcionar a las organizaciones editoriales una base de datos más sólida para negociar.
Fuente: imagen creada con ChatGPT.
Qué papel juegan los CMS en este nuevo paradigma
La llegada de estándares como Content Telemetry plantea una evolución para los CMS especializados en medios de comunicación, como bCube: ya no basta con gestionar qué contenido se publica y cómo se presenta al usuario. La arquitectura debe estar preparada para identificar los contenidos de forma inequívoca, exponer los metadatos necesarios y conectarse con las capas de infraestructura que intervienen en su distribución.
El estándar contempla diferentes puntos de observación, desde el servidor de origen hasta la CDN o edge (en nuestro caso, Transparent Edge) y permite correlacionar los eventos generados por distintos actores. En este contexto, un CMS para medios debería estar preparado para:
-
Mantener una identidad estable para cada contenido: disponer de una identidad consistente para cada artículo, vídeo, imagen u otro activo facilita su trazabilidad a través de diferentes sistemas o canales.
-
Gestionar metadatos y manifiestos: Content Telemetry contempla un manifiesto específico (.well-known/content-telemetry.json) que permite declarar información sobre cómo se implementa el estándar y dónde deben dirigirse determinados datos de telemetría. El CMS y el resto de infraestructura del medio deben poder convivir con este tipo de mecanismos de descubrimiento y configuración.
-
Integrarse con la infraestructura de distribución: la telemetría puede generarse desde el servidor de origen o desde la capa edge/CDN. Por ello, la arquitectura del CMS debe facilitar la integración con estos componentes y mantener una identificación coherente del contenido entre ellos.
-
Conectar la gestión de contenidos con los sistemas de analítica y gobernanza: a medida que los sistemas de IA generen nuevas señales sobre el uso de los contenidos, los medios necesitarán relacionarlas con sus propios datos editoriales, de audiencia y de negocio. El CMS debe formar parte de un ecosistema capaz de conectar estas fuentes de información.
-
Prepararse para una gestión más granular de los derechos de uso: Content Telemetry no determina qué contenidos pueden utilizarse ni establece las condiciones económicas. Sin embargo, su integración con protocolos de acceso y licenciamiento abre la puerta a una gestión cada vez más precisa de los permisos asociados a los contenidos y a su utilización por sistemas de IA.
En definitiva, el CMS deja de ser únicamente el lugar donde se crea y publica el contenido para convertirse en una pieza de una infraestructura más amplia en la que también importa su identidad, sus metadatos, sus condiciones de uso y la trazabilidad de su distribución.
−−−
Como hemos visto, la evolución de la IA hace que los medios se replanteen las preguntas sobre su contenido: cómo circula entre buscadores, agentes y sistemas de IA, qué valor aporta y qué ocurre después de ser recuperado. Estándares abiertos como Content Telemetry apuntan a esa dirección, un ecosistema en el que el uso de los contenidos puede describirse, medirse y, potencialmente, relacionarse con nuevos modelos de licencia y monetización.
En bCube DXP seguimos de cerca esta evolución porque entendemos que el CMS del futuro no será únicamente una herramienta para publicar contenidos, sino un sistema de referencia que mantiene la identidad, el contexto y los metadatos del contenido a lo largo de todo su ciclo de vida digital. En un ecosistema en el que buscadores, agentes y sistemas de IA participan cada vez más en su distribución y consumo, esa trazabilidad será cada vez más importante.